

Kursmaterial · Storycard
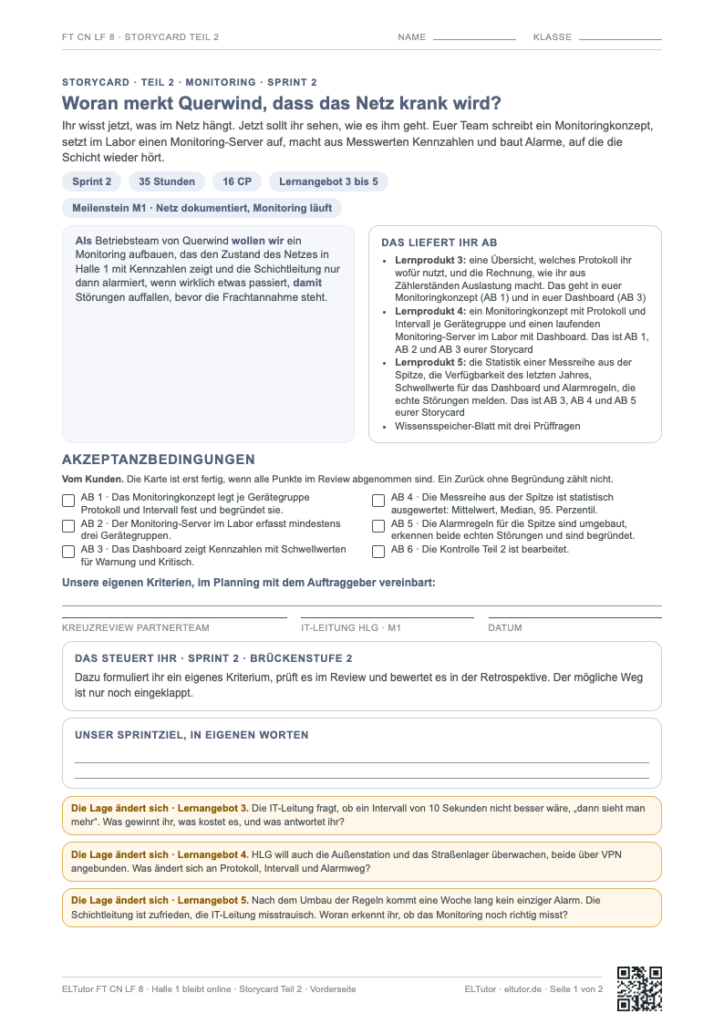
Die Storycard zu Teil 2. Zwei Seiten: vorne Story, Akzeptanzbedingungen und Sprintziel, hinten Anschluss, Kompetenzmodell und Retrospektive. Druckt sie doppelseitig aus.
Storycard Teil 2 herunterladen2 Seiten · doppelseitig drucken
Euer Board · AB 1 bis 6
Jede Akzeptanzbedingung eurer Storycard ist hier eine Karte. Schiebt sie mit den Pfeilen weiter: offen, in Arbeit, Review, fertig. Höchstens drei Karten gleichzeitig in „In Arbeit“: lieber eine Karte fertig machen als viele anfangen. „Fertig“ setzt den Haken in der AB-Liste, so seht ihr den Stand auch oben in der Leiste jeder Seite. Gespeichert wird im Browser dieses Geräts, am besten öffnet ihr das Board am Teamrechner.
Das Board lädt. Ohne JavaScript nutzt ihr die Rückseite der Storycard.
Sprint 2Meilenstein M1⏱ 35 h16 CP
Ihr wisst jetzt, was im Netz hängt. Jetzt sollt ihr sehen, wie es ihm geht. Euer Team schreibt ein Monitoringkonzept, setzt im Labor einen Monitoring-Server auf, macht aus Messwerten Kennzahlen und baut Alarme, auf die die Schicht wieder hört.
Sprint 2Brückenstufe 2
Eure Story: Ihr richtet ein Monitoring für das Netz des Hubs ein, legt Kennzahlen und Schwellwerte fest und baut die Alarme so, dass echte Störungen auffallen.
Hier startet euer Sprint. Storycard drucken, im Planning die Aufgaben im Team verteilen und AB 1 bis 6 festhalten.
Ihr lest Lage, Nachricht und Storycard, schätzt, wie oft das Monitoring in einer Nacht Alarm geben würde, und plant euren Weg durch Teil 2.
0 von 6 AB abgehakt AB-Liste öffnen
Agil arbeiten · Sprint 2
Eure Storycard für Teil 2 steuert diesen Sprint
Druckt sie doppelseitig aus, bevor ihr loslegt. Das ganze Team arbeitet an dieser Storycard, die Aufgaben verteilt ihr selbst. Die Akzeptanzbedingungen sind nummeriert (AB 1 bis n), genau so wie unten in „Fertig seid ihr, wenn …“. Die Kursseiten dieses Teils sind Inputs: Ihr holt sie euch, wenn eure Storycard danach fragt.
Das steuert ihr · Stufe 2: Dazu formuliert ihr ein eigenes Kriterium, prüft es im Review und bewertet es in der Retrospektive. Der mögliche Weg ist nur noch eingeklappt.
1 Planning2 Arbeiten mit Daily3 Review4 Retrospektive
Storycard Teil 2 herunterladen PDF · 2 Seiten · 370 KB
Im Projekt: Woran merkt Querwind, dass das Netz krank wird?
Deine Lernangebote in Teil 2
Fachgrundlage · SNMP, Monitoring und KennzahlenLernangebot 3 · MonitoringprotokolleLernangebot 4 · Monitoring-Server aufsetzenLernangebot 5 · Kennzahlen und Statistik
Die Karte kennst du von „Bevor du loslegst“. Sie zeigt, was du in diesem Teil lernst.
Der wichtigste Satz auf dieser Seite: Ein gutes Monitoring sieht alles und meldet wenig. Was es meldet, muss stimmen.
Check-in: Wo ist dir das schon begegnet?
Klick bei jedem Punkt an, wo er dir schon begegnet ist: im Betrieb, privat oder in einem früheren Lernfeld. Das ist keine Bewertung.
Wozu der Check-in?
Viele haben schon eine Ampel in einem Dashboard gesehen oder einen Alarm weggeklickt. Ein Monitoring selbst aufgesetzt und Schwellwerte aus einer Messreihe abgeleitet haben die wenigsten. Kreuz ehrlich an, wo dir die Punkte schon begegnet sind.
Darum geht es
Als Betriebsteam von Querwind wollen wir ein Monitoring aufbauen, das den Zustand des Netzes in Halle 1 mit Kennzahlen zeigt und die Schichtleitung nur dann alarmiert, wenn wirklich etwas passiert, damit Störungen auffallen, bevor die Frachtannahme steht.
Die Lage im Hub
Das Inventar aus Teil 1 steht, die Pläne sind auf Stand. Das Monitoring ist immer noch eine leere VM. Das alte Monitoring von vor Jahren hat die Schichtleitung irgendwann stumm geschaltet, weil es jeden Abend ununterbrochen Alarm gab.
Zwischen 20 und 23 Uhr ist das Netz unruhig: Alle Rampen arbeiten, die Scanner senden im Sekundentakt, um 23 Uhr beginnt die Nachtruhe. An Rampe 3 brechen in dieser Zeit immer wieder Scanner ab.
Euer Ergebnis in Teil 2: ein Monitoringkonzept, ein laufender Monitoring-Server im Labor mit Dashboard, die Statistik einer Messreihe aus der Spitze und Alarmregeln, auf die die Schicht wieder hört. Das ist Meilenstein M1.
Nacht im Dashboard
Die Antwortzeit an Rampe 3 von 18 bis 24 Uhr, Minute für Minute. Stell Schwelle und Dauer des Alarms ein und zähl mit, wie oft es klingelt. Welche Alarme echte Störungen sind, zeigt die Szene erst bei den Lösungen.
Hier erscheint die Szene „Nacht im Dashboard“: Antwortzeit je Minute von 18 bis 24 Uhr, eine Alarmschwelle und eine Mindestdauer zum Einstellen, die Alarme der Nacht werden gezählt.
Die Nachricht der Schichtleitung
Betreff: Euer Monitoring
Hallo, ich habe gehört, ihr baut ein Monitoring. Wir hatten schon mal eins, vor Jahren. Das hat abends ununterbrochen gepiept, irgendwann haben wir die Nachrichten auf stumm geschaltet.
Ich will eigentlich nur eins: Wenn an der Rampe gleich die Scanner ausfallen, will ich es wissen, bevor die Leute mit den Geräten in der Hand vor mir stehen. Und wenn alles läuft, will ich meine Ruhe.
Schichtleitung Hub, Spätschicht
Was im Lehrplan steht und wo es in Teil 2 vorkommt
| Im Lehrplan steht | Hier in Teil 2 |
|---|---|
| nutzen Netzwerk-Monitoring zur Überwachung des IT-Netzes | Auftrag, Lernangebote 3 bis 5 |
| Monitoringsoftware; Monitoringprotokolle | Fachgrundlage, Lernangebot 3 und 4 |
| Aufsetzen und Nutzen von Monitoringtools | Lernangebot 4: Monitoring-Server im Labor |
| Überwachung des Netzzustands mit Kennzahlen und Statistiken | Lernangebot 5, Szene „Nacht im Dashboard“ |
| Qualitätssicherung (Schwellwerte, Fehlalarme) | Aufgaben 5.4 und 5.5 |
Pflicht-Storycard Teil 2 · 16 CP · Sprint 2 · Brückenstufe 2 · Meilenstein M1
Als Schichtleitung im Hub will ich gewarnt werden, bevor die Scanner ausfallen, und nur dann, damit ich Alarme wieder ernst nehmen kann.
| Bereich | Anteil | Woran gemessen |
|---|---|---|
| Produkt | 40 % | Monitoringkonzept, Server im Labor, Dashboard, Statistik, Alarmregeln (AB 1 bis 5) |
| Prozess | 25 % | Aufgaben im Team verteilt, eigenes Kriterium formuliert und im Review geprüft, Wissensspeicher gepflegt |
| Wissen | 35 % | Kontrolle Teil 2, zehn Fragen (AB 6) |
Das steuert ihr (Brückenstufe 2)
Wie in Sprint 1, dazu formuliert ihr im Planning ein eigenes Kriterium, prüft es im Review und bewertet es in der Retrospektive.
Offener Fall der Storycard (Stufe III · Heuristik)
In der Spitze zwischen 20 und 23 Uhr meldet das Monitoring jede Nacht dutzendfach Alarm, die Schichtleitung schaut nicht mehr hin. Baut Schwellwerte und Alarmregeln so um, dass echte Störungen auffallen.
Das entscheidet ihr
Der Auftrag sagt, was erreicht sein muss. Wie ihr es erreicht, legt euer Team fest und begründet es.
- welches offene Monitoring-Werkzeug ihr im Labor nutzt
- welche Werte ihr je Gerätegruppe erfasst und in welchem Intervall, solange es begründet ist
- welche Kennzahlen oben im Dashboard stehen
- wo der Monitoring-Server läuft und wer ihn überwacht
- wie eure Alarmregeln aussehen, solange beide echten Störungen erkannt werden und die Schicht sie mitträgt
Erst schätzen, dann arbeiten
Schätze: Wie oft gibt das Monitoring mit der Regel von heute (eine Minute über 20 ms) in einer Nacht zwischen 18 und 24 Uhr Alarm? Und wie viele davon sind echte Störungen? Schreib zwei Zahlen auf. In der Szene „Nacht im Dashboard“ zählt ihr nach.
Die Auflösung steht bei den Rechenwegen und Lösungen dieses Teils.
Das steuert ihr in Sprint 2 · Brückenstufe 2
Wie in Stufe 1, dazu formuliert ihr im Planning ein eigenes Kriterium, prüft es im Review und bewertet es in der Retrospektive. Der mögliche Weg ist eingeklappt.
Der Kurs gibt vor: Story und AB. Alles Weitere sind Inputs, die ihr euch holt, wenn eure Storycard danach fragt.
Eure Aufgabenverteilung in Sprint 2: Das ganze Team arbeitet an dieser Storycard. Wer welche Aufgabe übernimmt, legt ihr im Planning fest und schreibt den Namen auf die Karte am Board. Den offenen Fall der Storycard entscheidet ihr gemeinsam.
Aus eurer letzten Retrospektive: Lest im Planning zuerst euren Satz „Das ändern wir im nächsten Sprint“ von der Rückseite der letzten Storycard vor. Er gilt in diesem Sprint als eure erste Teamregel.
In der Mitte des Sprints: Zwischenreview. Ihr zeigt eurem Partnerteam und dem Auftraggeber euren Stand am Board und holt euch Rückmeldung, solange ihr noch umsteuern könnt.
Ein möglicher Weg zu eurer Storycard
Ein Vorschlag für euer Backlog, kein Pflichtweg. Ab diesem Sprint ist er eingeklappt: wer welche Aufgabe übernimmt, Reihenfolge, Sprintziel und ein eigenes Kriterium legt ihr im Planning fest.
Vorschlag aufklappen, wenn ihr ihn braucht
Planning
Input
AB 1
AB 1
AB 2
AB 3
AB 4
AB 5
Review
Der Weg im Einzelnen
- Auftrag klären
Lest Lage, Nachricht und Storycard, verteilt die Aufgaben im Team, schreibt euer Sprintziel und ein eigenes Kriterium. (Planning) - Fachgrundlage
Lest die Fachgrundlage zu SNMP, Monitoring und Kennzahlen, so weit ihr sie braucht. (Input, nur so weit ihr ihn braucht) - Protokolle
Klärt, welches Protokoll ihr wofür nutzt, und rechnet Auslastung aus Zählern (Lernangebot 3, AB 1).
zahlt ein auf AB 1 - Konzept
Rechnet Abfragelast und Speicher und schreibt das Monitoringkonzept (Lernangebot 4, AB 1).
zahlt ein auf AB 1 - Server im Labor
Setzt den Monitoring-Server auf und bindet drei Gerätegruppen an (AB 2).
zahlt ein auf AB 2 - Dashboard
Baut das Dashboard mit Kennzahlen und Schwellwerten (Lernangebot 5, AB 3).
zahlt ein auf AB 3 - Statistik
Wertet die Messreihe aus der Spitze aus (AB 4).
zahlt ein auf AB 4 - Alarmregeln
Baut die Alarmregeln für die Spitze um und stimmt sie mit der Schichtleitung ab (AB 5).
zahlt ein auf AB 5 - Review und Kontrolle
Wissensspeicher-Blatt, Kreuzreview durch das Partnerteam, Kontrolle Teil 2, dann Review mit der IT-Leitung, Meilenstein M1 (AB 6). (Review gegen alle AB)
Fertig seid ihr, wenn … (AB 1 bis 6)
Fertig seid ihr, wenn das Partnerteam im Kreuzreview alle Akzeptanzbedingungen abnimmt:
- Das Monitoringkonzept legt je Gerätegruppe Protokoll und Intervall fest und begründet sie.
- Der Monitoring-Server im Labor erfasst mindestens drei Gerätegruppen.
- Das Dashboard zeigt Kennzahlen mit Schwellwerten für Warnung und Kritisch.
- Die Messreihe aus der Spitze ist statistisch ausgewertet: Mittelwert, Median, 95. Perzentil.
- Die Alarmregeln für die Spitze sind umgebaut, erkennen beide echten Störungen und sind begründet.
- Die Kontrolle Teil 2 ist bearbeitet.
Die Haken gelten für den ganzen Teil: Ihr seht den Stand in der Leiste oben auf jeder Seite, am Board und auf der Seite mit den Rechenwegen. Gespeichert wird im Browser dieses Geräts.
Das brauchst du dafür
- euer Inventar und eure Pläne aus Teil 1
- die Fachgrundlage dieses Teils und dein Tabellenbuch
- einen Laborrechner mit Docker oder einer VM, einen Laborswitch oder Netzsimulator, einen Raspberry Pi
- eine Tabellenkalkulation für Statistik und Verfügbarkeit
- eure Lehrkraft als IT-Leitung von HLG und als Schichtleitung
Rollen im Team für diesen Teil
Projektleitung (Zeit, Weg, Abstimmung mit IT-Leitung und Schicht), Protokolle und Konzept (Lernangebot 3 und 4), Server und Dashboard (Labor), Kennzahlen und Alarme (Lernangebot 5, Wissensspeicher). Die Projektleitung wechselt nach jedem Sprint.
Gegebene Werte für Teil 2 · aufklappen, wenn du sie brauchst
Gegebene Werte für Teil 2
- Monitoring-VM
- 4 vCPU, 16 GB RAM, leer
- Zu überwachen
- 49 Netzkomponenten aus dem Inventar von Teil 1, dazu 2 USV, 2 Virtualisierungshosts, 1 NAS, 14 virtuelle Maschinen
- Standard
- Abfrage alle 60 s, je Port 4 Zähler, je Gerät 6 Werte
- Alarmregel heute
- Alarm, sobald die Antwortzeit eine Minute lang über 20 ms liegt, per Kurznachricht an die Schichtleitung
- SLA
- 99,9 % Verfügbarkeit des Netzes für die Frachtannahme je Monat
- Spitze
- 20 bis 23 Uhr, Nachtruhe ab 23 Uhr
Unterrichtswerte, angelehnt an öffentliche Größenordnungen und übliche Marktgrößen 2026. Alle Teile rechnen mit denselben Zahlen.